Was ist der Unterschied zwischen On-Premise und Edge AI?
On-Premise AI und Edge AI bedeuten beide, dass KI lokal betrieben wird, sind aber nicht dasselbe. Bei On-Premise AI findet…

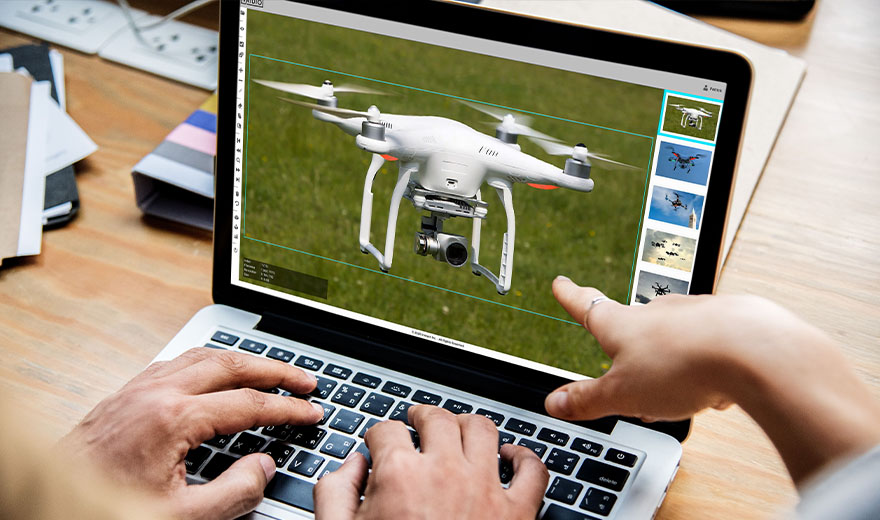
Ein Vision AI-Modell wird trainiert, indem es große Mengen an Beispielen analysiert und das Ergebnis immer wieder mit der richtigen Antwort vergleicht. Auf Grundlage seiner Fehler passt sich das Modell Schritt für Schritt an und wird dadurch immer besser darin, Muster zu erkennen. Bei Vision AI kann es beispielsweise darum gehen, Personen, Fahrzeuge, Schutzhelme oder andere Objekte in Bildern zu erkennen.
Ein Modell benötigt Beispiele. Angenommen, Sie möchten ein Vision AI-Modell darauf trainieren, Schutzhelme zu erkennen. Dann werden Bilder von Personen benötigt:
Je größer die Vielfalt der Trainingsdaten ist, desto höher ist die Wahrscheinlichkeit, dass das Modell auch in der Praxis mit unterschiedlichen Situationen gut umgehen kann.
Während des Trainings muss das Modell wissen, was die richtige Antwort ist. Deshalb werden Daten häufig gelabelt oder annotiert.
Zum Beispiel:
Bei der Objekterkennung wird häufig auch markiert, wo sich das Objekt genau im Bild befindet. Diese richtigen Antworten bilden die sogenannte Ground Truth.
Während des Trainings erstellt das KI-Modell eigene Vorhersagen. Zu Beginn liegen diese Vorhersagen häufig noch falsch. Anschließend wird die Vorhersage mit der Ground Truth verglichen. Auf Grundlage des Fehlers werden interne Parameter angepasst.
Dieser Prozess wird sehr oft wiederholt. Auf diese Weise lernt das Modell immer besser, welche visuellen Muster beispielsweise zu einer Person, einem Auto oder einem Schutzhelm gehören.
Ein Modell sollte nicht nur Bilder gut erkennen, die es bereits gesehen hat. Deshalb wird ein Teil der Daten für die Validierung zurückgehalten.
Die Frage lautet dann: Funktioniert das Modell auch gut bei Bildern, die nicht direkt Teil des Trainingsdatensatzes waren?
Die Fähigkeit, auch in neuen Situationen gute Ergebnisse zu erzielen, nennt man Generalisierung.
Gute Ergebnisse in einem Datensatz bedeuten nicht automatisch, dass ein Modell auch in einer realen Umgebung perfekt funktioniert. In der Praxis können unter anderem folgende Faktoren die Leistung beeinflussen:
Deshalb bleiben Tests in der tatsächlichen Einsatzumgebung wichtig.
Wenn ein KI-Modell einmal trainiert wurde und anschließend neue Bilder analysiert, spricht man von Inference. In dieser Phase wird das Gelernte praktisch angewendet.
Das bedeutet nicht automatisch, dass diese neuen Kamerabilder erneut zum Trainieren des Modells verwendet werden. Diese Unterscheidung ist besonders bei Themen wie Datenschutz und Datennutzung wichtig.
Manche Situationen treten nur selten auf oder sind schwer aufzuzeichnen. In solchen Fällen können synthetische Daten verwendet werden: künstlich erzeugte Bilder, mit denen zusätzliche Vielfalt und seltene Szenarien in die Trainingsdaten aufgenommen werden können.
So kann ein Modell besser auf Situationen vorbereitet werden, die sich in der realen Welt nur schwer sammeln lassen.