Datasoevereiniteit bij Vision AI gaat om controle, niet alleen om locatie
Door Kasper van Kekem, CEO VAIBS Wanneer ik gesprekken voer over Vision AI, merk ik dat datasoevereiniteit steeds vaker ter…

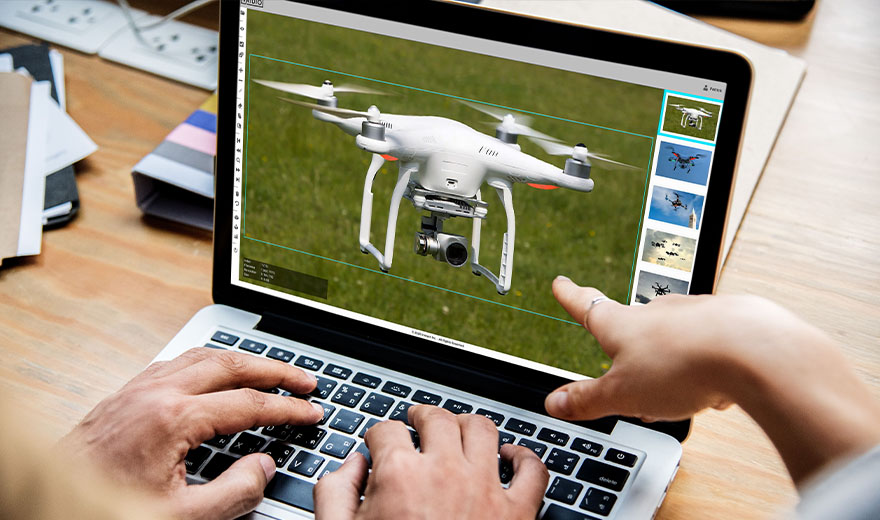
Een Vision AI-model wordt getraind door het grote hoeveelheden voorbeelden te laten analyseren en de uitkomst steeds te vergelijken met het juiste antwoord. Op basis van de fouten past het model zichzelf stap voor stap aan, totdat het steeds beter wordt in het herkennen van patronen. Bij Vision AI gaat dat bijvoorbeeld om het herkennen van personen, voertuigen, veiligheidshelmen of andere objecten in beeld.
Een model heeft voorbeelden nodig. Stel dat je een Vision AI-model wilt trainen om veiligheidshelmen te herkennen. Dan zijn beelden nodig van mensen:
Hoe beter de variatie in de trainingsdata, hoe groter de kans dat het model ook in de praktijk goed omgaat met verschillende situaties.
Het model moet tijdens training weten wat het juiste antwoord is. Daarom wordt data vaak gelabeld of geannoteerd.
Bijvoorbeeld:
Bij objectdetectie wordt vaak ook aangegeven waar het object zich precies in beeld bevindt. Die juiste antwoorden vormen de zogenaamde ground truth.
Tijdens training probeert het AI-model zelf voorspellingen te maken. In het begin zitten die voorspellingen er nog al eens naast. De voorspelling wordt vervolgens vergeleken met de ground truth. Op basis van de fout worden interne parameters aangepast. Dat proces wordt heel vaak herhaald. Zo leert het model steeds beter welke visuele patronen horen bij bijvoorbeeld een persoon, auto of veiligheidshelm.
Een model mag niet alleen goed zijn in het herkennen van beelden die het al heeft gezien. Daarom wordt een deel van de data apart gehouden voor validatie. De vraag is dan: Werkt het model ook goed op beelden die niet letterlijk in de trainingsset zaten? Dat vermogen om nieuwe situaties goed te herkennen noemen we generaliseren.
Goede resultaten in een dataset betekenen niet automatisch dat een model ook perfect werkt in een echte omgeving. In de praktijk spelen factoren mee zoals:
Daarom blijft testen in de werkelijke omgeving belangrijk.
Wanneer een AI-model eenmaal is getraind en daarna nieuwe beelden analyseert, spreken we over inference. Het geleerde wordt hier in praktijk toegepast. Dat betekent niet automatisch dat die nieuwe camerabeelden opnieuw worden gebruikt om het model te trainen. Dit onderscheid is belangrijk bij onderwerpen als privacy en datagebruik.
Sommige situaties komen weinig voor of zijn moeilijk vast te leggen. Dan kan synthetische data worden gebruikt: kunstmatig gegenereerde beelden waarmee extra variatie en zeldzame scenario’s kunnen worden toegevoegd aan de trainingsdata. Zo kan een model breder worden voorbereid op situaties die in de echte wereld lastig te verzamelen zijn.